
Claude 5.5 怎么选
范围清楚的活用 Sonnet。又长又含糊、要它自己收尾的用 Opus。摘要、分类和子任务用 Haiku,但单次 prompt 别过 10 万 token。三档都已在目录里。
先选档,再看价
三档都是 1M 上下文,2026 年 6 月的知识截止。差别在于你把哪类活交给它。
- Sonnet 5.5,修 bug、写文档、做幻灯片、改界面。输入 / 输出 $2 / $10,缓存命中 $0.10。Claude 应用里默认 effort 是 medium,这才是它比 Opus 便宜的区域。Platform 默认 high,费用会靠近 Opus。
- Opus 5.5,跨仓库、边界含糊、要它自己收尾。$4 / $20,缓存命中 $0.20。Thinking 不能关。要更快再开 Fast,同一份 token 大约贵一倍,而且只在第一方 API。
- Haiku 5.5,压缩、摘要、分类、客服,以及给上面两档当子任务。不超过 10 万 token 时是 $0.10 / $0.50,缓存命中 $0.01。一过线,整单变成 5 倍,不是只给超出的那一段加价。
- Fable 5.1 先留着。它仍是 $10 / $50。编码的默认已经不是它。
目录里的首见日期:Opus 2026-09-23,Sonnet 09-30,Haiku 10-08。OpenRouter 主 listing 对得上上面的输入 / 输出;Haiku 那一行只是不超过 10 万的低档。三档都没有直连价,也没有缓存列。缓存和 Haiku 高档以平台定价页为准。
要看的是缓存命中,不是标价
 点击放大图片
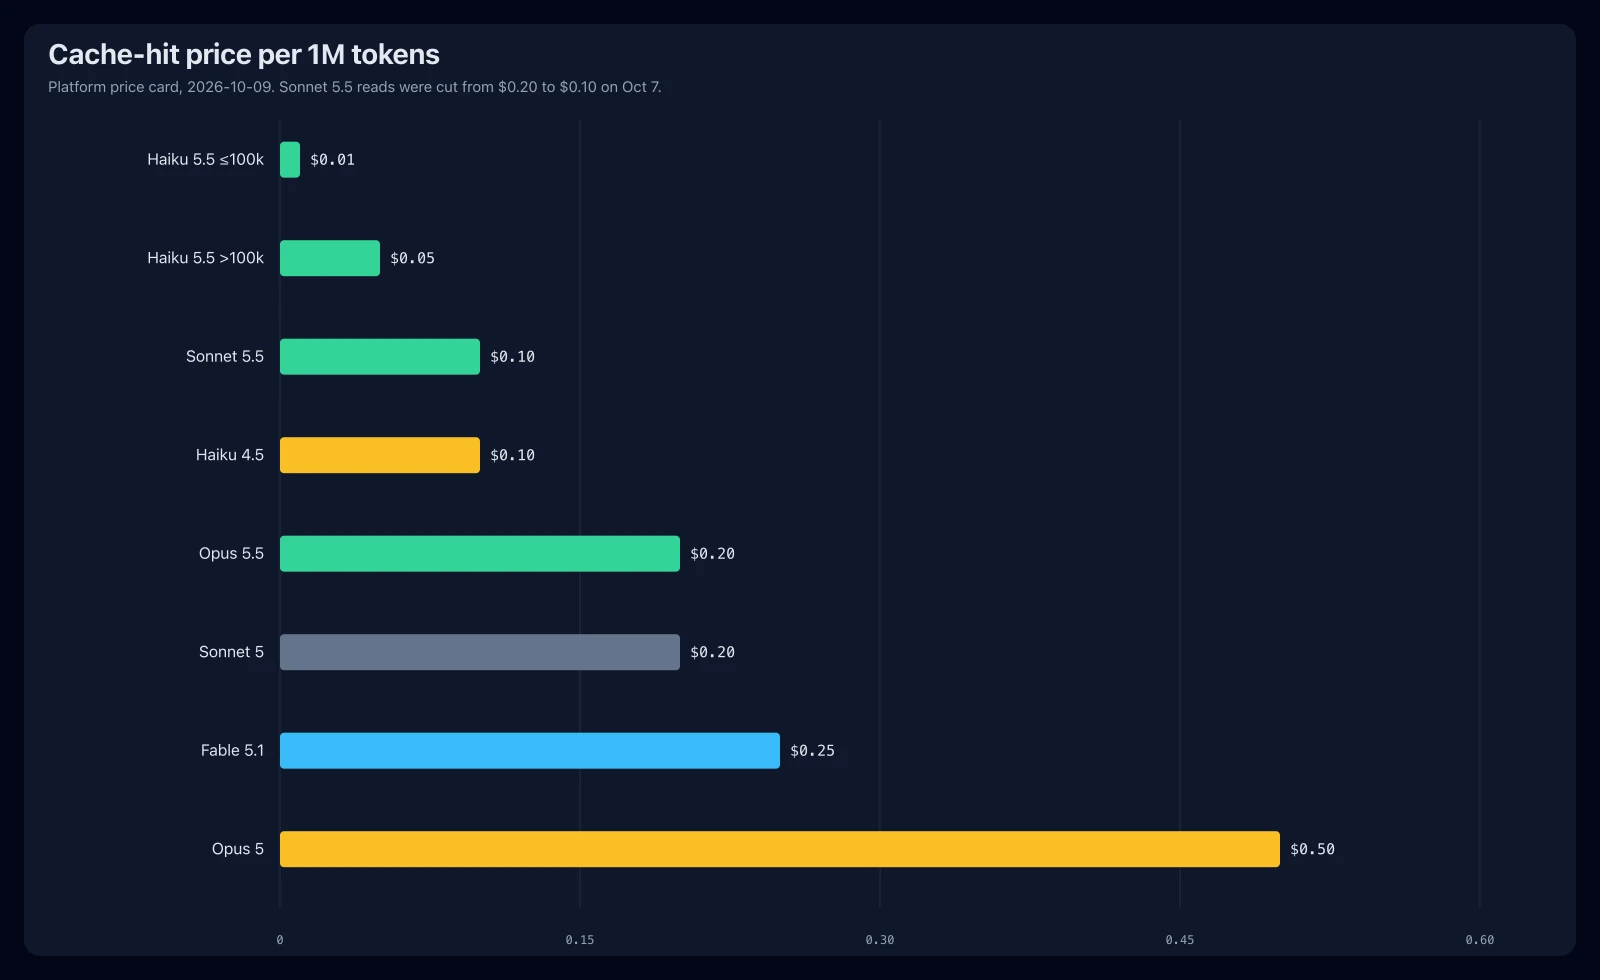
编码和长对话里,大部分 token 是缓存读,不是新输入。所以 Sonnet 和 Opus 的输入都没怎么动,命中价才是这次真正的变化:Sonnet 从 $0.20 降到 $0.10,Opus 从 $0.50 降到 $0.20。
| 型号 | 输入 | 输出 | 缓存命中 |
|---|---|---|---|
| Opus 5.5 | $4 | 本组最优 $20 | $0.20 |
| Opus 5 | $5 | 本组最优 $25 | $0.50 |
| Sonnet 5.5 | $2 | 本组最优 $10 | $0.10 |
| Sonnet 5 | $2 | 本组最优 $10 | $0.20 |
| Haiku 5.5 ≤100k | $0.10 | $0.50 | 本组最优 $0.01 |
| Haiku 5.5 >100k | $0.50 | $2.50 | 本组最优 $0.05 |
| Haiku 4.5 | $1 | 本组最优 $5 | $0.10 |
| Fable 5.1 | $10 | 本组最优 $50 | $0.25 |
- 5 分钟的缓存写入是输入价的 1.25 倍,命中一次就回本。1 小时是 2 倍,要命中两次。
- Batch 是输入和输出各半价。它和缓存叠在一起之后的合价,定价页没有单独的格子,这里不算。
- 指定美国推理会把整单再乘 1.1。下面的账按全球默认,不乘这个数。
- Haiku 的 10 万把缓存读写都算进 prompt。99,000 和 100,001 不是多一点点,是整张账单翻 5 倍。
- 别把 $1 到 $0.10 读成「账单变成十分之一」。新 tokenizer 同一段文字大约多出 30% token。Anthropic 说平均大约便宜 75%,这个数已经把 tokenizer 算进去了。
同一份 token,两张账单
 点击放大图片
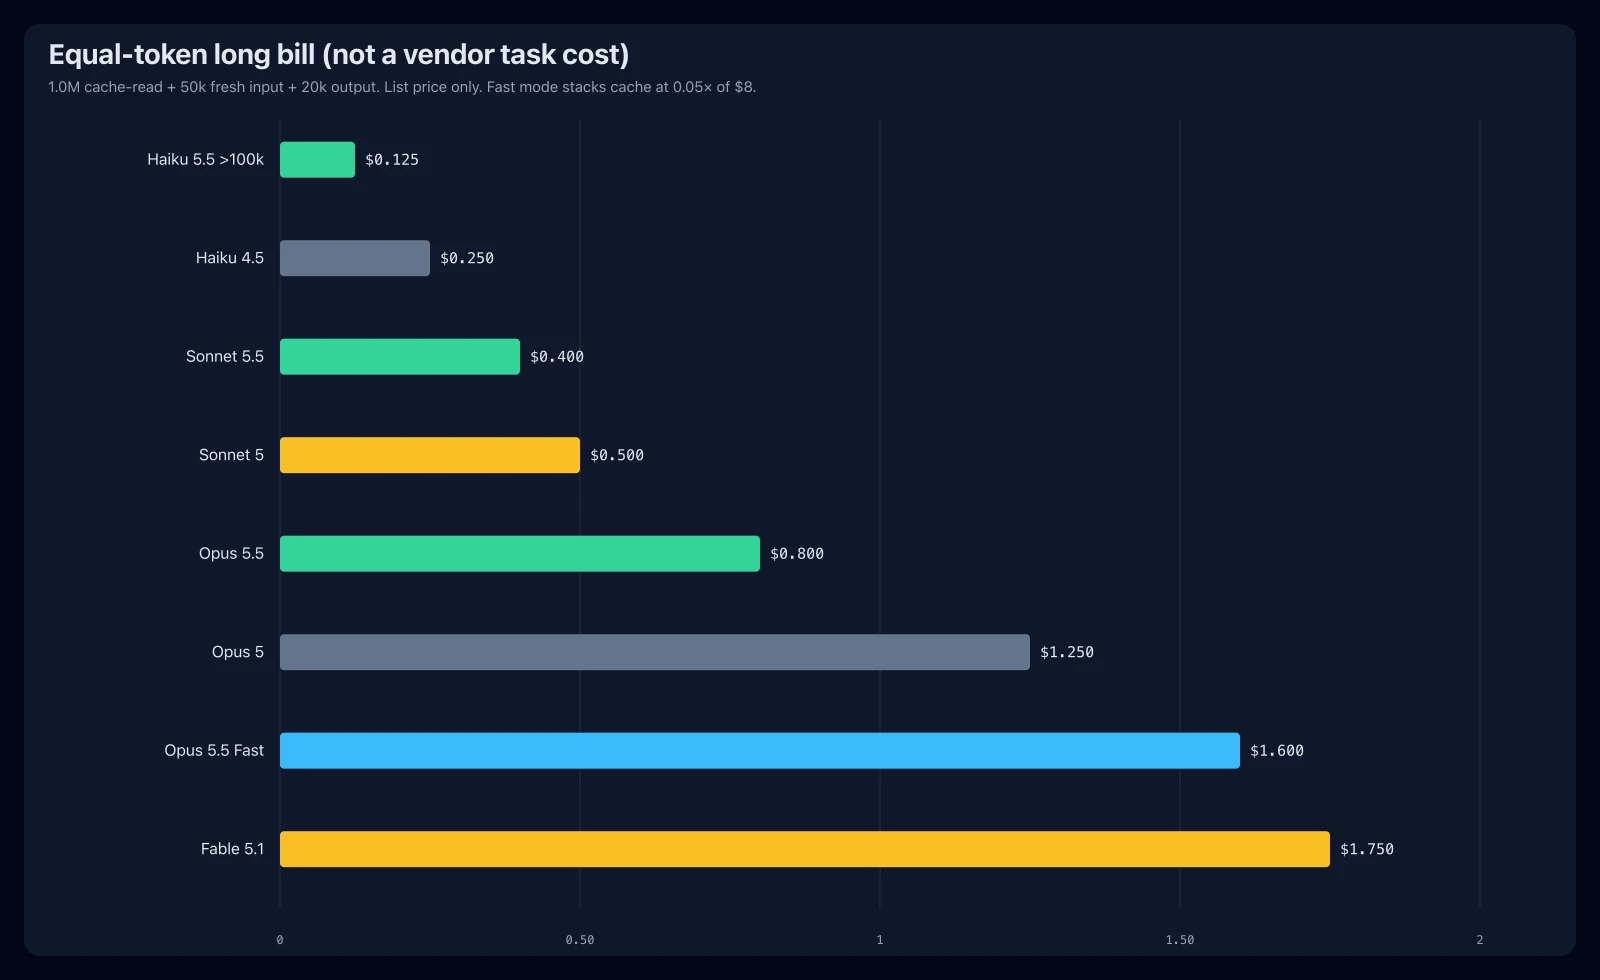
厂商说的「便宜 40% / 30% / 75%」把两件事混在一起:标价变了,同一件事用的 token 也变了。下面把 token 锁死,只算标价。
短请求是 8 万缓存读、1.5 万新输入、4 千输出。Prompt 共 9.5 万,Haiku 走低档。长任务是 100 万缓存读、5 万新输入、2 万输出。Prompt 超过 10 万,Haiku 整单走高档。
| 型号 | 短请求 | 长任务 |
|---|---|---|
| Haiku 5.5 | $0.0043 | 本组最优 $0.125 |
| Haiku 4.5 | $0.043 | 本组最优 $0.250 |
| Sonnet 5.5 | $0.078 | 本组最优 $0.400 |
| Sonnet 5 | $0.086 | 本组最优 $0.500 |
| Opus 5.5 | $0.156 | 本组最优 $0.800 |
| Opus 5 | $0.215 | 本组最优 $1.250 |
| Opus 5.5 Fast | $0.312 | 本组最优 $1.600 |
| Fable 5.1 | $0.370 | 本组最优 $1.750 |
- 长任务里,Opus 5.5 是 $0.80,上一代是 $1.25,少 36%。他们说的大约 40% 还含「用了更少 token」,那一部分不在这张表里。
- Sonnet 5.5 是 $0.40,上一代是 $0.50,正好少 20%。你的流量如果几乎没有缓存,标价和 Sonnet 5 相同,省钱只来自更少的 token。
- 短请求里 Haiku 5.5 是 $0.0043,大约是 Sonnet 的 1/18、Opus 的 1/36。这就是把它当子任务的理由。过了 10 万,这个差距会缩一截。
Sonnet 的那一格更高,不要据此换掉 Opus
 点击放大图片
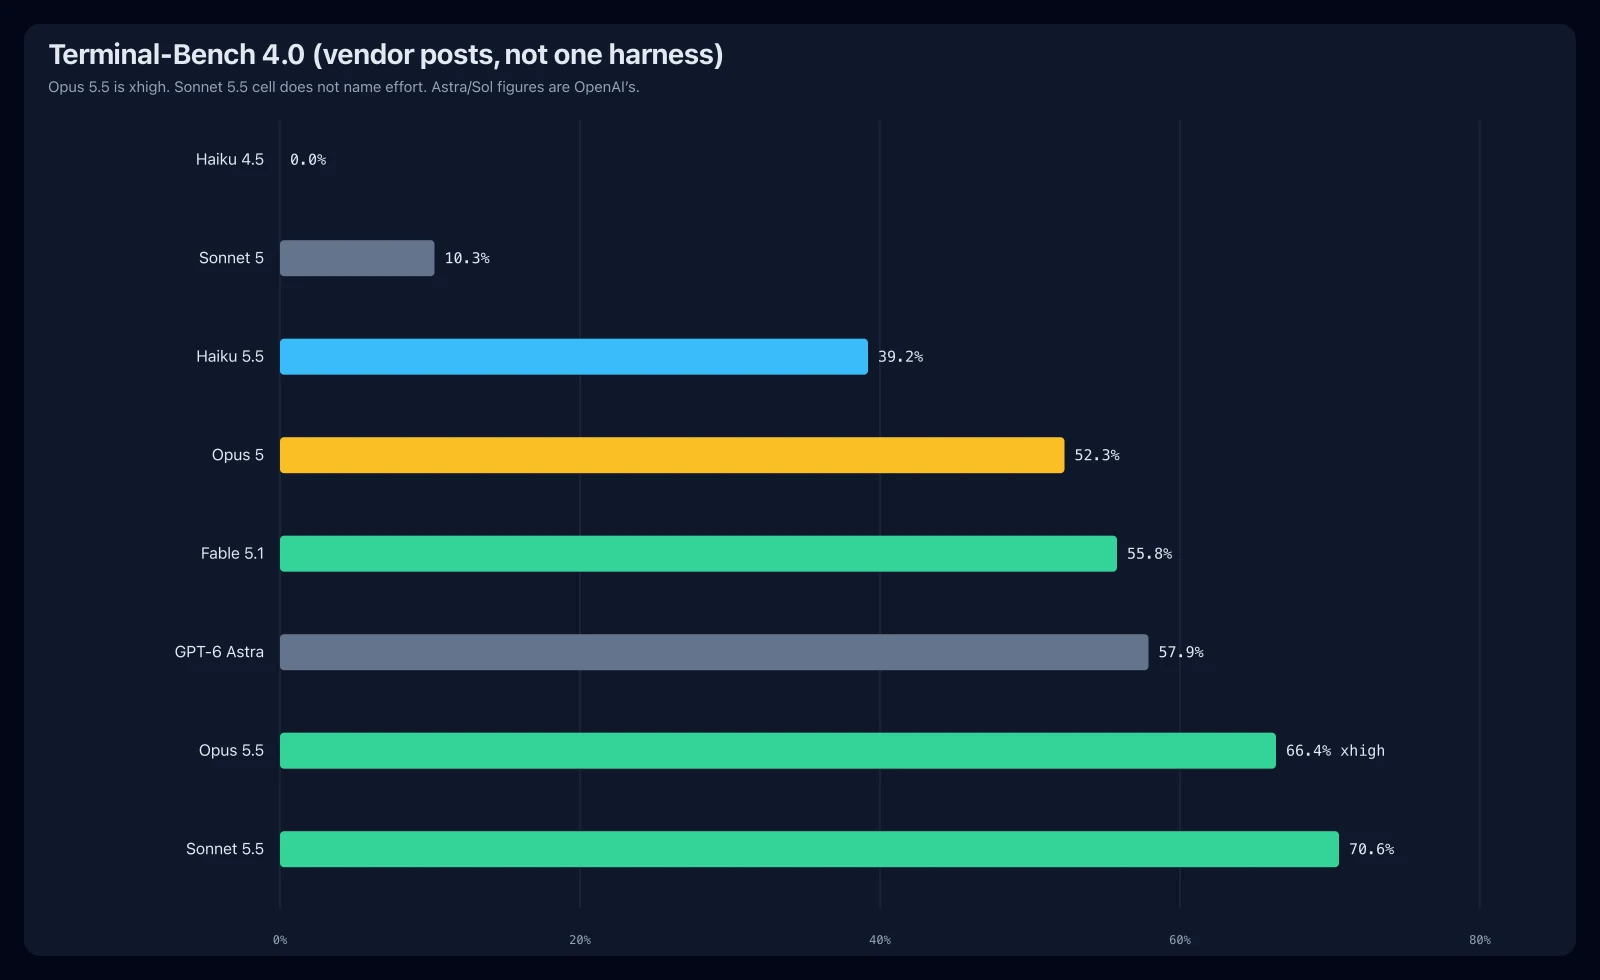
表里只放标题数字。读的时候记住三句,比记住整表有用。
| 测试 | Haiku 5.5 | Sonnet 5.5 | Opus 5.5 |
|---|---|---|---|
| Terminal-Bench 4.0 | 39.2% | 本组最优 70.6% | 66.4% |
| FrontierCode | 46.4% | 52.1% | 本组最优 54.4% |
| CursorBench | — | 55.5% | 本组最优 57.8% |
| GDPval-AA | 1620 | 1844 | 本组最优 1846 |
- Terminal-Bench 上 Sonnet 是 70.6%,Opus 是 66.4%。Opus 写明是最高档 xhigh,Sonnet 那一格没写档位。上一代 Sonnet 是 10.3%,Haiku 4.5 是 0。相对上一代是断层,相对 Opus 不是「已经全面超过」。
- FrontierCode 看的是改动能不能合并。Opus 大约 54%,Sonnet 在 xhigh 是 52.1%,拧到 max 反而掉到 46.2%,因为审查被拆给太多子任务,改出了题面。把 effort 拧满,这张表会变差。
- CursorBench 上 Sonnet 的 55.5% 落在 Opus 的 medium(52.5%)和 max(57.8%)之间,不是稳定的第二名。GDPval 几乎打平:1844 对 1846。Haiku 发布稿把 Sonnet 印成 1840,差 4 分,当同一档。
- 有两张图不能横比。Chartography 有的带工具、有的不带。OSWorld 的 partial 和 offline 也不是同一套。
- Opus 没赢的也留着:AutomationBench 上 GPT-6 Astra 是 41.4%,Opus 是 40.0%。科学终端任务上 Astra 是 64.6%,Opus 是 58.7%。安全回退会把分压低,因为拦截之后换了别的模型去完成。
Anthropic 自己写了:这些分差比他们内部用起来的差距更宽。开放式、要一直做判断的活,仍然是 Opus。
换过去时,这三件事会变
- Thinking。 Opus 5.5 不能关掉。工具调用之间的文字,在默认设置里回到空的 thinking 块;如果你拿它当进度条,中间会变静,直到改 display。Sonnet 如果以前是 thinking off,先改成 between_tools 再迁。
- 账号绑死。 Opus 5.5 从 2026-08-31 及之后的 API 账号起,不能改写它已经写下的上文来抽取推理。Sonnet 5.5 是第一档这样做的 Sonnet。对话不能随便搬到另一个账号,Claude Code 里中途换账号也会踩到。
- 安全回退。 网络安全类请求,Opus 5.5 多半退回 Opus 4.8,Sonnet 5.5 退回 Sonnet 5。日常改 bug 还在。Haiku 对防御更宽,渗透测试仍然拦住。生物研发若被 Opus 挡住,要走 Life Sciences 审核;Sonnet 和 Haiku 的生物防护与 Sonnet 5 相同。
Opus 5.5 和 Sonnet 5.5 可以零数据保留。Haiku 的发布稿没有写这句,这里不补。Max 和 Team 的每月 API 额度是订阅信用,不是折扣:5x 为 $100,20x 为 $200,Team 最多 $500,成员共用。