
Como escolher no Claude 5.5
Trabalho delimitado: Sonnet. Longo, ambíguo e que tenha de fechar sozinho: Opus. Resumos, classificação e subtarefas: Haiku, sem passar de 100.000 tokens num prompt. As três linhas já estão no catálogo.
Escolha primeiro, olhe o preço depois
Os três têm contexto de 1M e corte de conhecimento em junho de 2026. O que muda é o trabalho que lhes dá.
- Sonnet 5.5. Bugs, documentos, slides, interface. Entrada / saída $2 / $10, acerto de cache $0.10. Nas apps o effort por defeito é medium: aí é mais barato que o Opus. Na Platform o defeito é high, e o custo aproxima-se do Opus.
- Opus 5.5. Vários repositórios, limites pouco claros, que feche sozinho. $4 / $20, acerto $0.20. Não dá para desligar o thinking. Fast só se a latência importar: os mesmos tokens custam o dobro, e só na API de primeira parte.
- Haiku 5.5. Compactar, resumir, classificar, suporte, e subtarefas dos dois de cima. Até 100.000 tokens: $0.10 / $0.50, acerto $0.01. Ao passar, o request inteiro vale 5×, não só o excesso.
- Fable 5.1 continua a $10 / $50. Já não é o default de código.
Primeira aparição: Opus 2026-09-23, Sonnet 09-30, Haiku 10-08. O listing OpenRouter bate com entrada e saída; a linha do Haiku é só a faixa baixa. Nenhum tem preço direto nem coluna de cache.
Olhe o acerto de cache, não o sticker
 Ampliar imagem
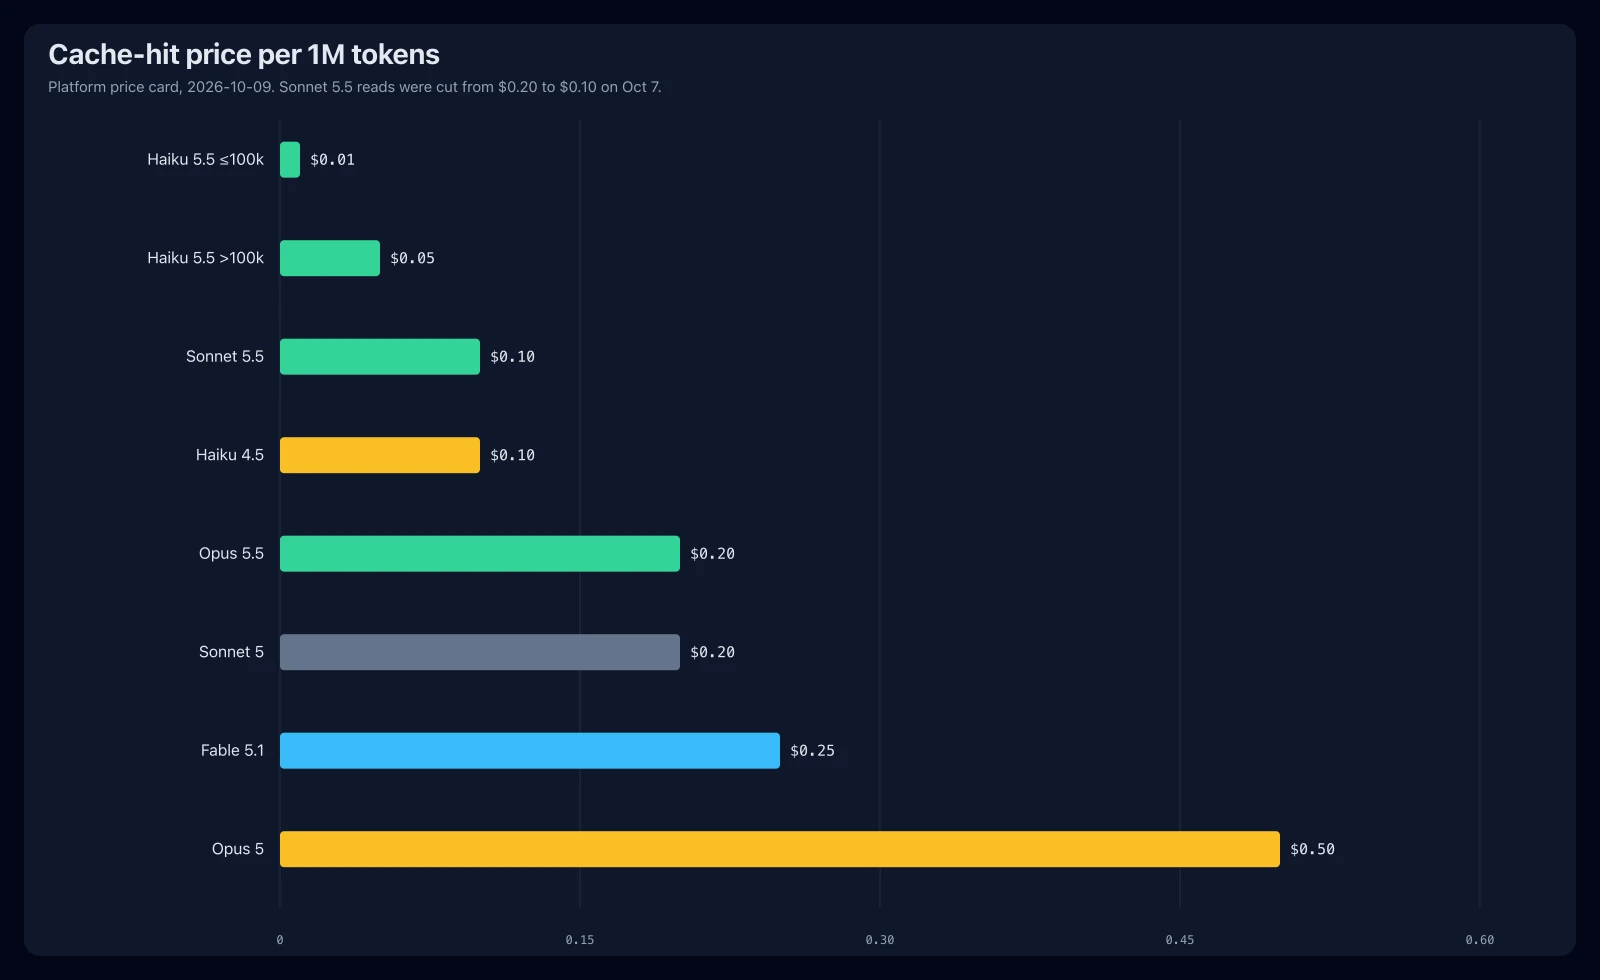
Em código e em conversas longas, a maioria dos tokens são leituras de cache, não input novo. O sticker de entrada e saída quase não mexeu. O que mudou foi o acerto: Sonnet de $0.20 para $0.10, Opus de $0.50 para $0.20.
| Modelo | Entrada | Saída | Acerto |
|---|---|---|---|
| Opus 5.5 | $4 | Melhor nesta comparação $20 | $0.20 |
| Opus 5 | $5 | Melhor nesta comparação $25 | $0.50 |
| Sonnet 5.5 | $2 | Melhor nesta comparação $10 | $0.10 |
| Sonnet 5 | $2 | Melhor nesta comparação $10 | $0.20 |
| Haiku 5.5 ≤100k | $0.10 | $0.50 | Melhor nesta comparação $0.01 |
| Haiku 5.5 >100k | $0.50 | $2.50 | Melhor nesta comparação $0.05 |
| Haiku 4.5 | $1 | Melhor nesta comparação $5 | $0.10 |
| Fable 5.1 | $10 | Melhor nesta comparação $50 | $0.25 |
- Escrever cache de 5 minutos custa 1.25× a entrada e paga-se com um acerto. O de 1 hora custa 2× e paga-se com dois.
- Batch põe entrada e saída a metade. A página não publica a célula combinada com cache; aqui não a invento.
- Pedir inferência nos EUA multiplica tudo por 1.1. As contas abaixo usam o encaminhamento global.
- Os 100.000 do Haiku contam leituras e escritas de cache. 99.000 e 100.001 não é um acréscimo suave: é ×5 na fatura toda.
- Não leia $1 → $0.10 como «a fatura cai para um décimo». O tokenizer novo emite ~30% mais tokens para o mesmo texto. O «~75% menos em média» da Anthropic já inclui isso.
Os mesmos tokens, duas faturas
 Ampliar imagem
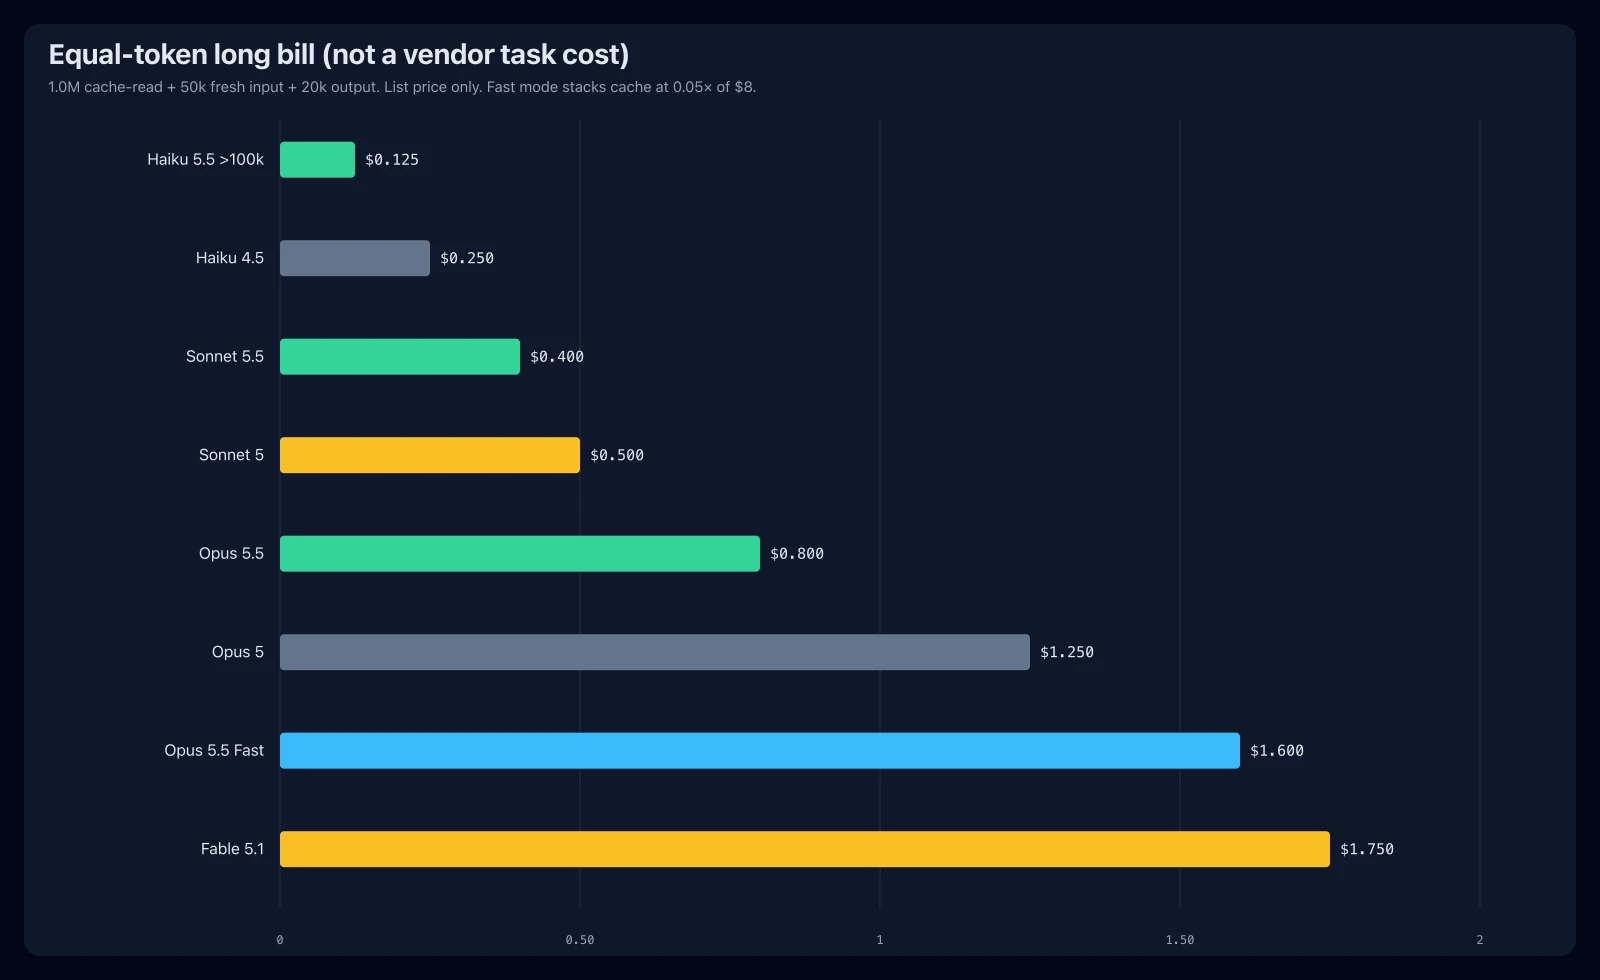
O «40% / 30% / 75% mais barato» mistura duas coisas: o sticker mudou e mudou quantos tokens são precisos. Aqui os tokens ficam fixos.
O request curto é 80.000 de cache, 15.000 de input novo e 4.000 de saída. O prompt soma 95.000 e o Haiku fica na faixa baixa. O longo é 1.000.000 de cache, 50.000 novos e 20.000 de saída. O prompt passa de 100.000 e o Haiku vai inteiro para a faixa alta.
| Modelo | Curto | Longo |
|---|---|---|
| Haiku 5.5 | $0.0043 | Melhor nesta comparação $0.125 |
| Haiku 4.5 | $0.043 | Melhor nesta comparação $0.250 |
| Sonnet 5.5 | $0.078 | Melhor nesta comparação $0.400 |
| Sonnet 5 | $0.086 | Melhor nesta comparação $0.500 |
| Opus 5.5 | $0.156 | Melhor nesta comparação $0.800 |
| Opus 5 | $0.215 | Melhor nesta comparação $1.250 |
| Opus 5.5 Fast | $0.312 | Melhor nesta comparação $1.600 |
| Fable 5.1 | $0.370 | Melhor nesta comparação $1.750 |
- No longo, Opus 5.5 custa $0.80 e o anterior $1.25, menos 36%. Os ~40% que eles citam incluem ainda menos tokens, e isso não está na tabela.
- Sonnet 5.5 custa $0.40 e o anterior $0.50, exactamente menos 20%. Se quase não há cache, o sticker é o do Sonnet 5 e a poupança vem só de menos tokens.
- No curto, Haiku 5.5 custa $0.0043: cerca de 1/18 do Sonnet e 1/36 do Opus. É por isso que serve de subtarefa. Passados os 100.000, essa vantagem encolhe.
Sonnet marca mais alto numa célula. Não aposente o Opus por isso
 Ampliar imagem
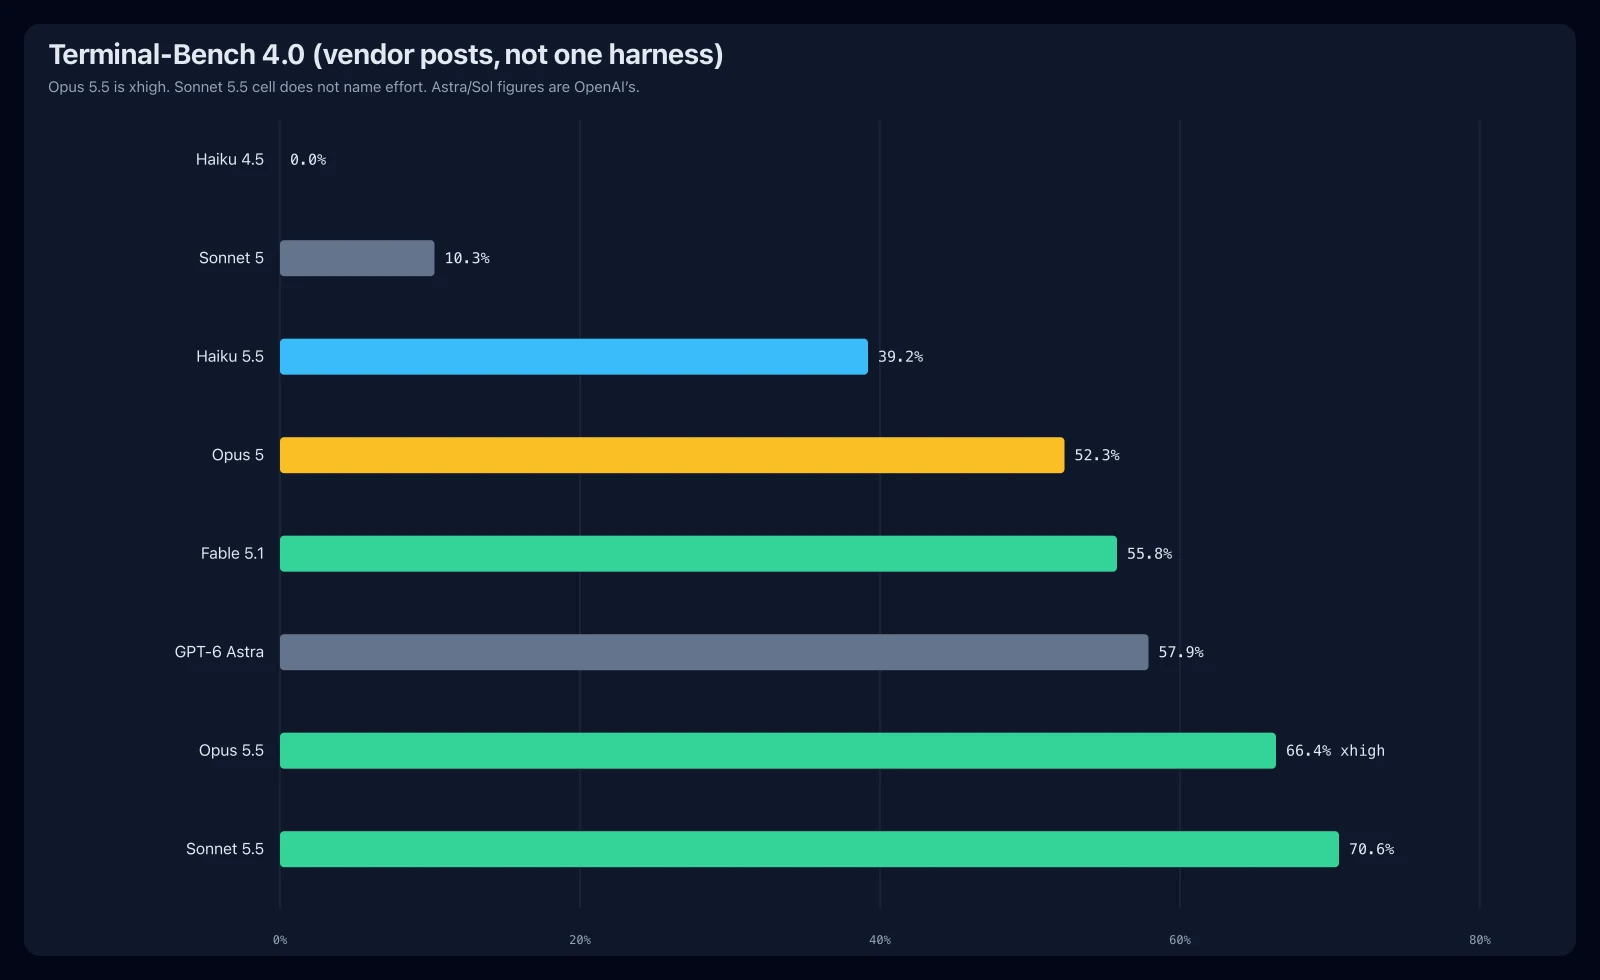
A tabela só tem o número de título. Estas três ideias importam mais do que decorar a tabela.
| Teste | Haiku 5.5 | Sonnet 5.5 | Opus 5.5 |
|---|---|---|---|
| Terminal-Bench 4.0 | 39.2% | Melhor nesta comparação 70.6% | 66.4% |
| FrontierCode | 46.4% | 52.1% | Melhor nesta comparação 54.4% |
| CursorBench | — | 55.5% | Melhor nesta comparação 57.8% |
| GDPval-AA | 1620 | 1844 | Melhor nesta comparação 1846 |
- No Terminal-Bench, Sonnet é 70.6% e Opus 66.4%. Opus diz que é xhigh, o máximo. A célula do Sonnet não diz o nível. O Sonnet anterior é 10.3% e o Haiku 4.5 é 0. É um salto face à geração anterior, não um «já ultrapassa o Opus em tudo».
- FrontierCode vê se a alteração seria merged. Opus anda pelos 54%. Sonnet faz 52.1% em xhigh e cai para 46.2% em max, porque a revisão parte-se em demasiadas subtarefas e sai do enunciado. Subir o effort ao máximo piora esta tabela.
- No CursorBench, os 55.5% do Sonnet caem entre o medium do Opus (52.5%) e o max (57.8%). Não é um segundo lugar estável. GDPval está quase empatado: 1844 contra 1846. O post do Haiku imprime Sonnet como 1840; quatro pontos, a mesma faixa.
- Não misture dois gráficos. Chartography às vezes tem ferramentas e às vezes não. O partial e o offline do OSWorld também não são o mesmo conjunto.
- Opus não ganha tudo. No AutomationBench, GPT-6 Astra é 41.4% e Opus 40.0%. Na tarefa científica de terminal, Astra é 64.6% e Opus 58.7%. Os fallback de segurança baixam o número, porque outro modelo acaba a tarefa.
A Anthropic escreve que estas margens são mais largas do que a diferença que vêem ao usar. O trabalho aberto, o que pede julgamento seguido, continua a ser do Opus.
Três coisas que mudam na migração
- Thinking. Opus 5.5 não se desliga. O texto entre ferramentas volta, por defeito, em blocos de thinking vazios. Se isso era o progresso, fica em silêncio até mudar o display. Se o Sonnet ia com thinking off, passe a between_tools antes de migrar.
- Preso à conta. Em contas API de 2026-08-31 em diante, Opus 5.5 não deixa reescrever o que já escreveu para extrair o raciocínio. Sonnet 5.5 é o primeiro Sonnet que faz o mesmo. Mover uma conversa para outra conta, ou mudar de conta a meio do Claude Code, esbarra nisso.
- O fallback de segurança. Em ciber, a maior parte do Opus 5.5 cai para Opus 4.8 e o Sonnet 5.5 cai para Sonnet 5. Corrigir bugs do dia a dia continua. Haiku deixa mais defesa e continua a bloquear o pentest. Se o Opus bloquear biologia, o caminho é a verificação de Life Sciences. Sonnet e Haiku usam a mesma proteção biológica que o Sonnet 5.
Retenção zero está escrita para Opus 5.5 e Sonnet 5.5. O post do Haiku não o diz, e não se acrescenta aqui. O crédito mensal de Max e Team não é um desconto: 5x são $100, 20x são $200, Team até $500 partilhado.