
Comment choisir dans Claude 5.5
Travail cadré : Sonnet. Long, flou, et qui doit se fermer seul : Opus. Résumés, classement et sous-tâches : Haiku, sans dépasser 100 000 tokens dans un prompt. Les trois lignes sont déjà au catalogue.
Choisissez d’abord, le prix ensuite
Les trois ont un contexte de 1M et une coupure de connaissances en juin 2026. Ce qui change, c’est le travail que vous leur donnez.
- Sonnet 5.5. Bugs, documents, slides, interface. Entrée / sortie $2 / $10, lecture de cache $0.10. Dans les apps, l’effort par défaut est medium : c’est là qu’il est moins cher qu’Opus. Sur Platform le défaut est high, et le coût se rapproche d’Opus.
- Opus 5.5. Plusieurs dépôts, limites floues, il doit fermer seul. $4 / $20, lecture $0.20. Thinking ne se coupe pas. Fast seulement si la latence compte : les mêmes tokens coûtent le double, et seulement sur l’API première partie.
- Haiku 5.5. Compacter, résumer, classer, support, et sous-tâches des deux autres. Jusqu’à 100 000 tokens : $0.10 / $0.50, lecture $0.01. Au-delà, toute la requête passe à 5×, pas seulement le dépassement.
- Fable 5.1 reste à $10 / $50. Ce n’est plus le défaut pour le code.
Première apparition : Opus 2026-09-23, Sonnet 09-30, Haiku 10-08. Le listing OpenRouter correspond à l’entrée et à la sortie ; la ligne Haiku n’est que le palier bas. Aucune n’a de prix direct ni de colonne cache.
Regardez la lecture de cache, pas le tarif affiché
 Agrandir l’image
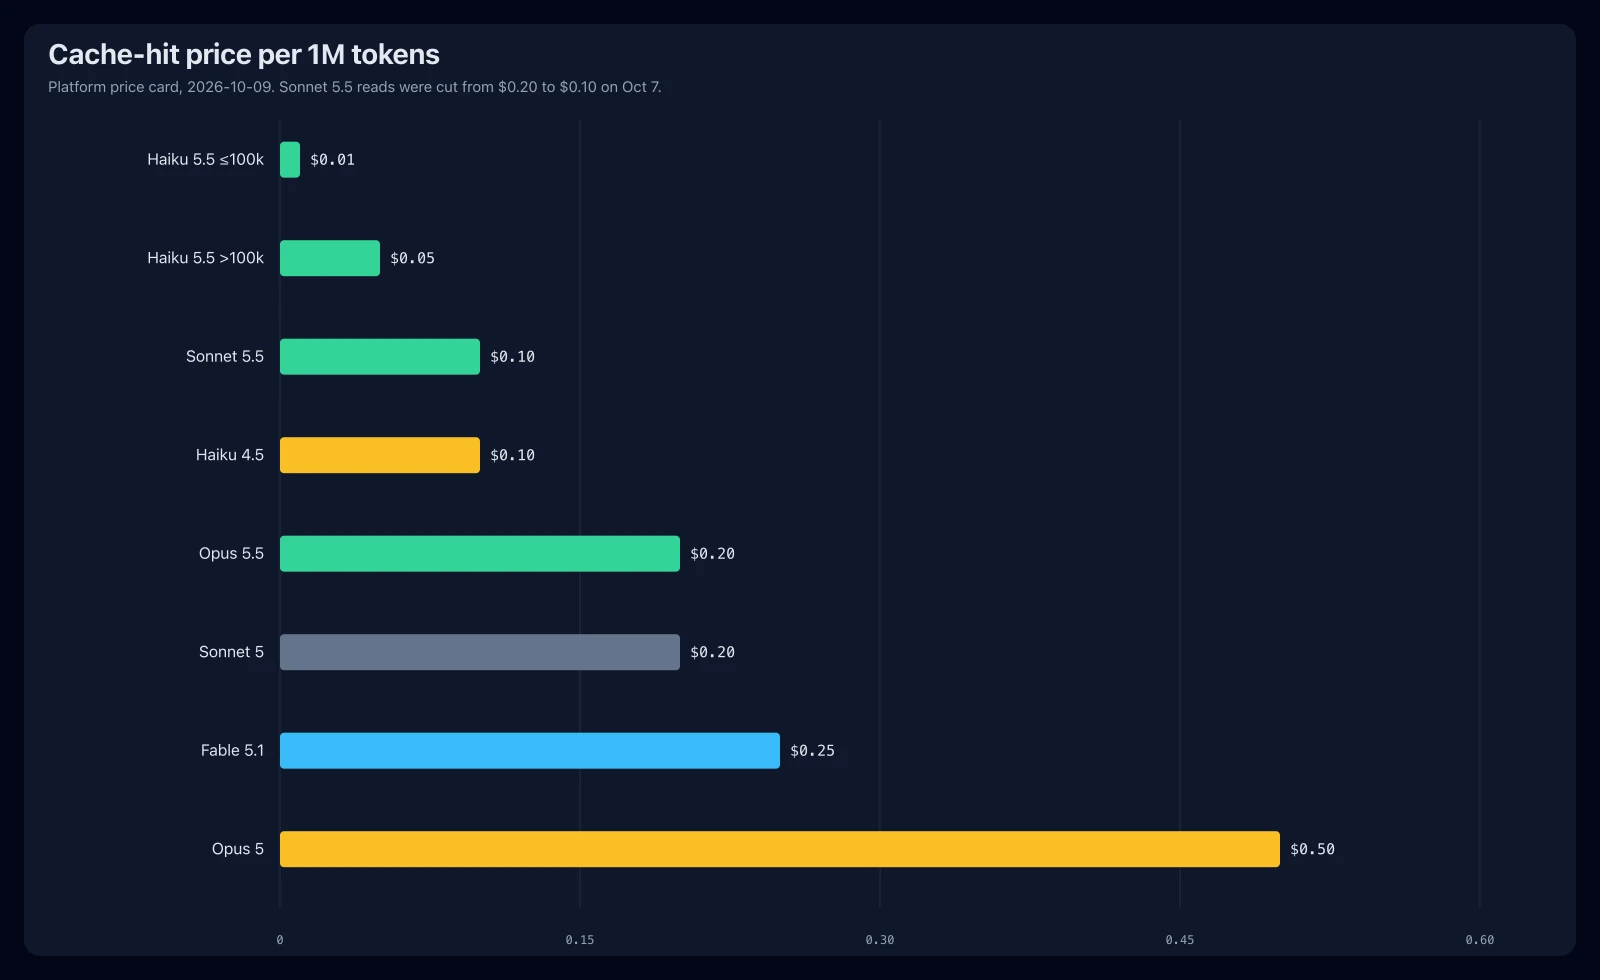
En code et dans les longues conversations, la plupart des tokens sont des lectures de cache, pas de l’input neuf. Le tarif entrée / sortie a peu bougé. Ce qui a bougé, c’est la lecture : Sonnet de $0.20 à $0.10, Opus de $0.50 à $0.20.
| Modèle | Entrée | Sortie | Lecture |
|---|---|---|---|
| Opus 5.5 | $4 | Meilleur de cette comparaison $20 | $0.20 |
| Opus 5 | $5 | Meilleur de cette comparaison $25 | $0.50 |
| Sonnet 5.5 | $2 | Meilleur de cette comparaison $10 | $0.10 |
| Sonnet 5 | $2 | Meilleur de cette comparaison $10 | $0.20 |
| Haiku 5.5 ≤100k | $0.10 | $0.50 | Meilleur de cette comparaison $0.01 |
| Haiku 5.5 >100k | $0.50 | $2.50 | Meilleur de cette comparaison $0.05 |
| Haiku 4.5 | $1 | Meilleur de cette comparaison $5 | $0.10 |
| Fable 5.1 | $10 | Meilleur de cette comparaison $50 | $0.25 |
- Une écriture de cache de 5 minutes vaut 1,25× l’entrée et se rembourse en une lecture. Celle d’1 heure vaut 2× et se rembourse en deux.
- Le batch met entrée et sortie à moitié. La page ne publie pas la case combinée avec le cache ; elle n’est pas calculée ici.
- Demander une inférence aux États-Unis multiplie tout par 1,1. Les comptes plus bas sont au routage global.
- Les 100 000 de Haiku comptent lectures et écritures de cache. 99 000 et 100 001 n’est pas un petit supplément : c’est ×5 sur toute la facture.
- Ne lisez pas $1 → $0.10 comme « la facture est divisée par dix ». Le nouveau tokenizer émet ~30 % de tokens en plus pour le même texte. Le « environ 75 % moins cher en moyenne » d’Anthropic inclut déjà ça.
Les mêmes tokens, deux factures
 Agrandir l’image
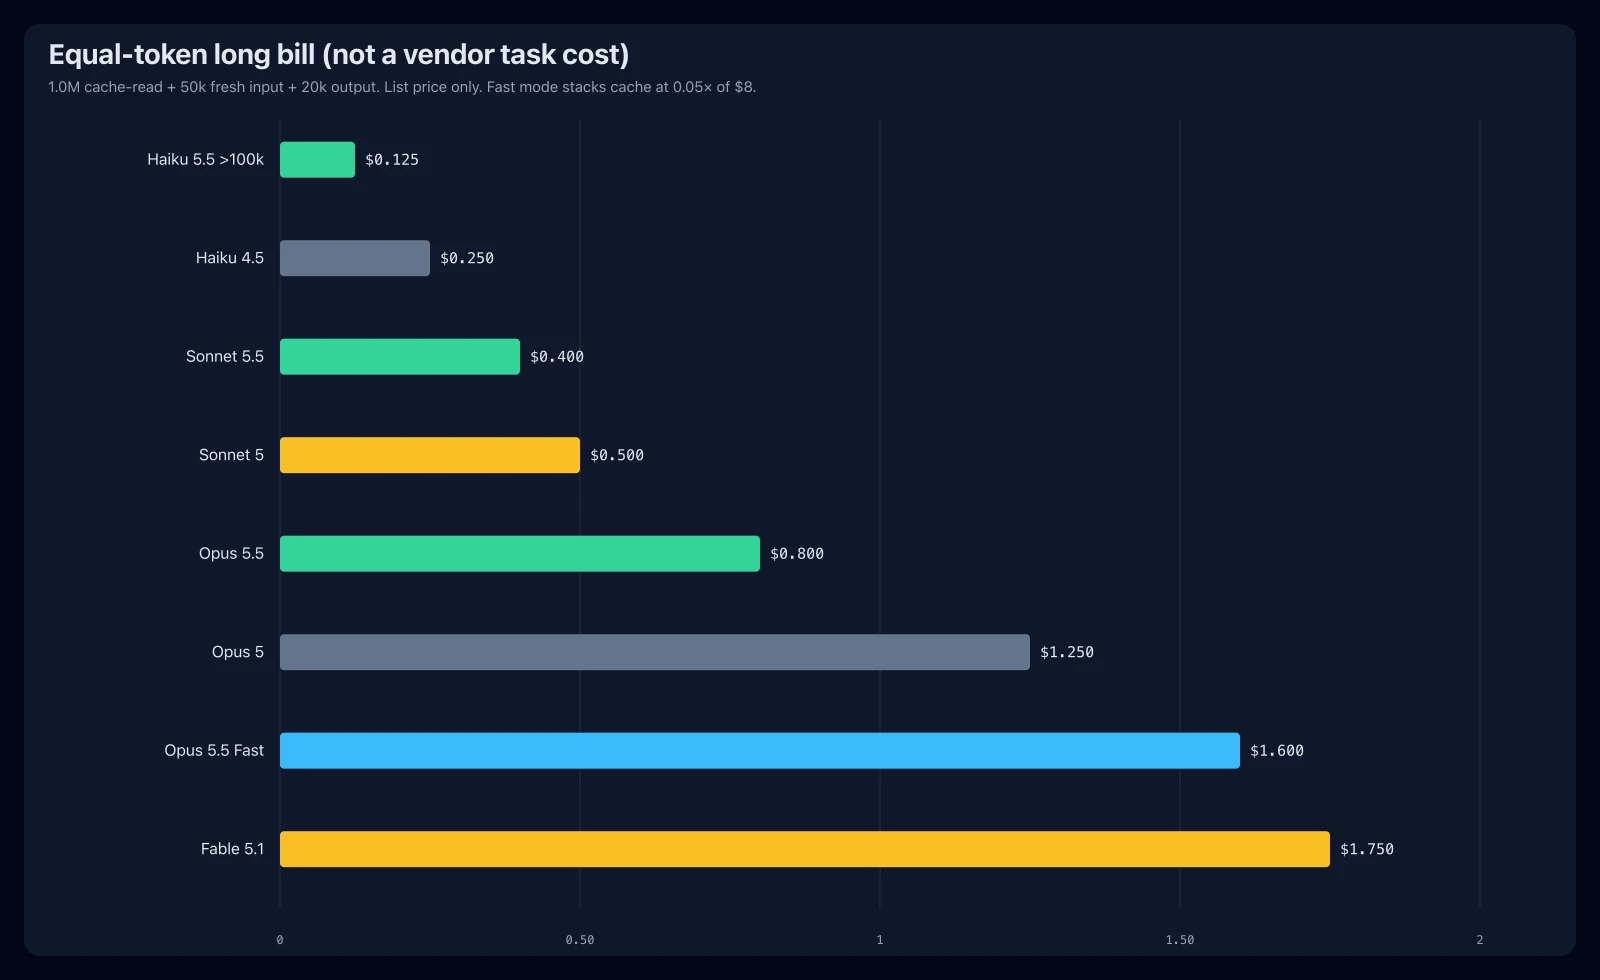
Le « 40 % / 30 % / 75 % moins cher » mélange deux choses : le tarif a changé, et le nombre de tokens aussi. Ici les tokens sont figés.
La requête courte, c’est 80 000 de cache, 15 000 d’input neuf et 4 000 de sortie. Le prompt fait 95 000 et Haiku reste au palier bas. La longue, c’est 1 000 000 de cache, 50 000 neufs et 20 000 de sortie. Le prompt dépasse 100 000 et Haiku passe entier au palier haut.
| Modèle | Court | Long |
|---|---|---|
| Haiku 5.5 | $0.0043 | Meilleur de cette comparaison $0.125 |
| Haiku 4.5 | $0.043 | Meilleur de cette comparaison $0.250 |
| Sonnet 5.5 | $0.078 | Meilleur de cette comparaison $0.400 |
| Sonnet 5 | $0.086 | Meilleur de cette comparaison $0.500 |
| Opus 5.5 | $0.156 | Meilleur de cette comparaison $0.800 |
| Opus 5 | $0.215 | Meilleur de cette comparaison $1.250 |
| Opus 5.5 Fast | $0.312 | Meilleur de cette comparaison $1.600 |
| Fable 5.1 | $0.370 | Meilleur de cette comparaison $1.750 |
- Sur le long, Opus 5.5 coûte $0.80 et le précédent $1.25, soit 36 % de moins. Les ~40 % cités incluent en plus moins de tokens, et ça n’est pas dans la table.
- Sonnet 5.5 coûte $0.40 et le précédent $0.50, exactement 20 % de moins. S’il n’y a presque pas de cache, le tarif est celui de Sonnet 5 et l’économie ne vient que des tokens en moins.
- Sur le court, Haiku 5.5 coûte $0.0043 : environ 1/18 de Sonnet et 1/36 d’Opus. C’est pour ça qu’il sert de sous-tâche. Passés les 100 000, cet écart se réduit.
Sonnet est plus haut dans une case. Ne retirez pas Opus pour ça
 Agrandir l’image
La table ne garde que le chiffre de titre. Ces trois idées comptent plus que la table entière.
| Test | Haiku 5.5 | Sonnet 5.5 | Opus 5.5 |
|---|---|---|---|
| Terminal-Bench 4.0 | 39.2% | Meilleur de cette comparaison 70.6% | 66.4% |
| FrontierCode | 46.4% | 52.1% | Meilleur de cette comparaison 54.4% |
| CursorBench | — | 55.5% | Meilleur de cette comparaison 57.8% |
| GDPval-AA | 1620 | 1844 | Meilleur de cette comparaison 1846 |
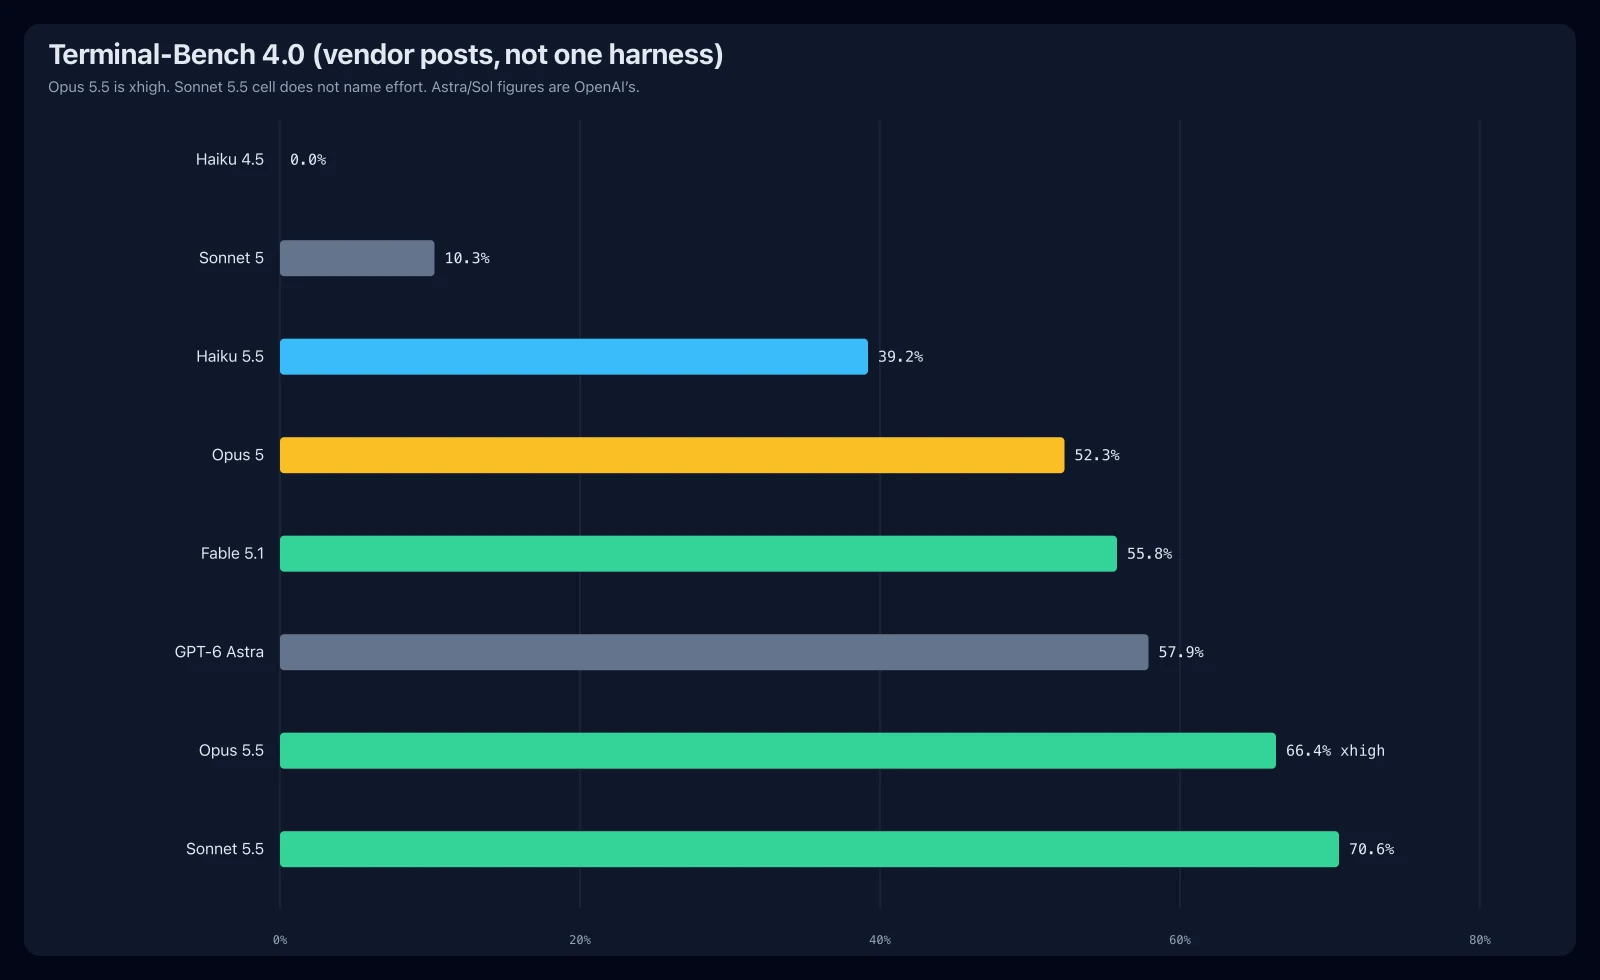
- Sur Terminal-Bench, Sonnet est à 70,6 % et Opus à 66,4 %. Opus précise que c’est xhigh, son maximum. La case Sonnet ne donne pas le niveau. L’ancien Sonnet est à 10,3 % et Haiku 4.5 à 0. C’est une rupture face à la génération d’avant, pas un « il dépasse déjà Opus partout ».
- FrontierCode regarde si le changement serait mergé. Opus est autour de 54 %. Sonnet fait 52,1 % en xhigh et tombe à 46,2 % en max, parce que la revue se découpe en trop de sous-tâches et sort de l’énoncé. Monter l’effort au maximum dégrade cette table.
- Sur CursorBench, les 55,5 % de Sonnet tombent entre le medium d’Opus (52,5 %) et son max (57,8 %). Pas une deuxième place stable. GDPval est presque à égalité : 1844 contre 1846. Le billet Haiku imprime Sonnet à 1840 ; quatre points, même bande.
- Ne mélangez pas deux graphiques. Chartography est parfois avec outils, parfois sans. Le partial et l’offline d’OSWorld ne sont pas le même jeu.
- Opus ne gagne pas tout. Sur AutomationBench, GPT-6 Astra est à 41,4 % et Opus à 40,0 %. Sur la tâche scientifique en terminal, Astra est à 64,6 % et Opus à 58,7 %. Les replis de sécurité baissent le chiffre, parce qu’un autre modèle finit la tâche.
Anthropic écrit que ces marges sont plus larges que l’écart qu’ils voient en l’utilisant. Le travail ouvert, celui qui demande un jugement suivi, reste à Opus.
Trois choses qui changent à la migration
- Thinking. Opus 5.5 ne se coupe pas. Le texte entre les outils revient, par défaut, dans des blocs thinking vides. Si vous l’affichiez comme progression, ça se tait tant que display n’est pas changé. Si Sonnet tournait thinking off, passez à between_tools avant de migrer.
- Lié au compte. Sur les comptes API créés le 2026-08-31 ou après, Opus 5.5 ne laisse pas réécrire ce qui est déjà écrit pour en extraire le raisonnement. Sonnet 5.5 est le premier Sonnet dans ce cas. Déplacer une conversation vers un autre compte, ou changer de compte au milieu de Claude Code, bute là-dessus.
- Le repli de sécurité. En cyber, la plupart d’Opus 5.5 retombe sur Opus 4.8 et Sonnet 5.5 retombe sur Sonnet 5. Corriger les bugs du quotidien reste possible. Haiku laisse plus de défense et bloque toujours le pentest. Si Opus bloque la biologie, le chemin est la vérification Life Sciences. Sonnet et Haiku ont la même protection biologique que Sonnet 5.
La rétention zéro est écrite pour Opus 5.5 et Sonnet 5.5. Le billet Haiku ne le dit pas, et ce n’est pas ajouté ici. Le crédit mensuel Max et Team n’est pas une remise : 5x fait $100, 20x fait $200, Team jusqu’à $500 partagé.