
Claude 5.5 の選び方
範囲が決まった作業は Sonnet。長く曖昧で、自分で閉じさせるなら Opus。要約・分類・サブタスクは Haiku。ただし 1 回の prompt は 10 万トークンを超えないこと。3 段ともカタログにある。
先に段を決める
3段とも文脈は 1M、知識の区切りは 2026年6月。違いは、どの仕事を渡すか。
- Sonnet 5.5。バグ修正、文書、スライド、UI。入出力 $2 / $10、キャッシュヒット $0.10。アプリの既定 effort は medium で、ここが Opus より安い領域。Platform の既定は high で、費用は Opus に寄る。
- Opus 5.5。複数リポジトリ、境界が曖昧、自分で閉じさせる。$4 / $20、ヒット $0.20。Thinking は切れない。速さが要るときだけ Fast。同じトークン数で約2倍、第一方 API のみ。
- Haiku 5.5。圧縮、要約、分類、サポート、そして上の2段のサブタスク。10万トークン以下なら $0.10 / $0.50、ヒット $0.01。超えると請求全体が5倍。はみ出した分だけではない。
- Fable 5.1 はまだ $10 / $50。コーディングの既定ではない。
カタログ初出:Opus 2026-09-23、Sonnet 09-30、Haiku 10-08。OpenRouter の主 listing は上の入出力と一致。Haiku の行は10万以下の段だけ。3段とも直結価格もキャッシュ列もない。
見るのはキャッシュヒット
 画像を拡大
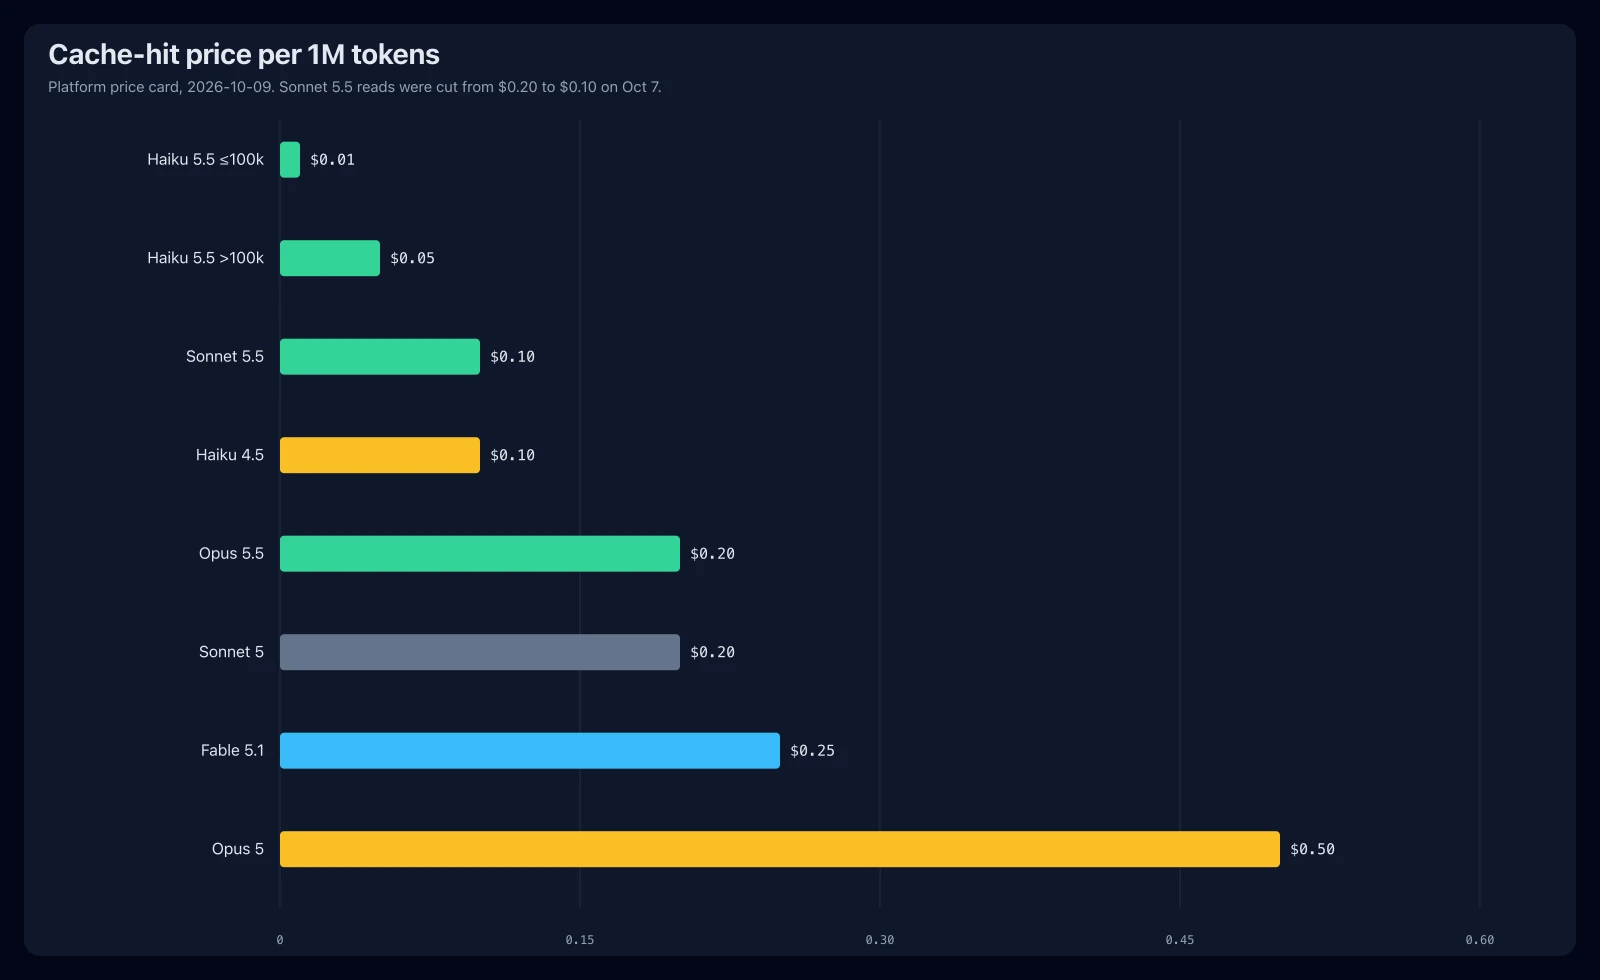
コーディングと長い会話では、トークンの大半は新しい入力ではなくキャッシュ読み。入出力の定価はあまり動いていない。動いたのはヒット単価で、Sonnet は $0.20 から $0.10、Opus は $0.50 から $0.20。
| モデル | 入力 | 出力 | ヒット |
|---|---|---|---|
| Opus 5.5 | $4 | この比較で最良 $20 | $0.20 |
| Opus 5 | $5 | この比較で最良 $25 | $0.50 |
| Sonnet 5.5 | $2 | この比較で最良 $10 | $0.10 |
| Sonnet 5 | $2 | この比較で最良 $10 | $0.20 |
| Haiku 5.5 ≤100k | $0.10 | $0.50 | この比較で最良 $0.01 |
| Haiku 5.5 >100k | $0.50 | $2.50 | この比較で最良 $0.05 |
| Haiku 4.5 | $1 | この比較で最良 $5 | $0.10 |
| Fable 5.1 | $10 | この比較で最良 $50 | $0.25 |
- 5分のキャッシュ書き込みは入力の 1.25 倍。ヒット1回で元が取れる。1時間は2倍で、ヒット2回。
- Batch は入出力が半額。キャッシュと重ねた合計は料金表にセルがないので、ここでは計算しない。
- 米国推論を指定すると全体がさらに 1.1 倍。下の請求はグローバル既定で、この 1.1 は掛けない。
- Haiku の10万にはキャッシュの読み書きも入る。99,000 と 100,001 は少し高いのではなく、請求全体が5倍。
- $1 から $0.10 を「請求が10分の1」と読まない。新しい tokenizer は同じ文章で約30%多くトークンを出す。Anthropic の「平均約75%安い」は、その分をすでに含む。
同じトークン数で二枚の請求
 画像を拡大
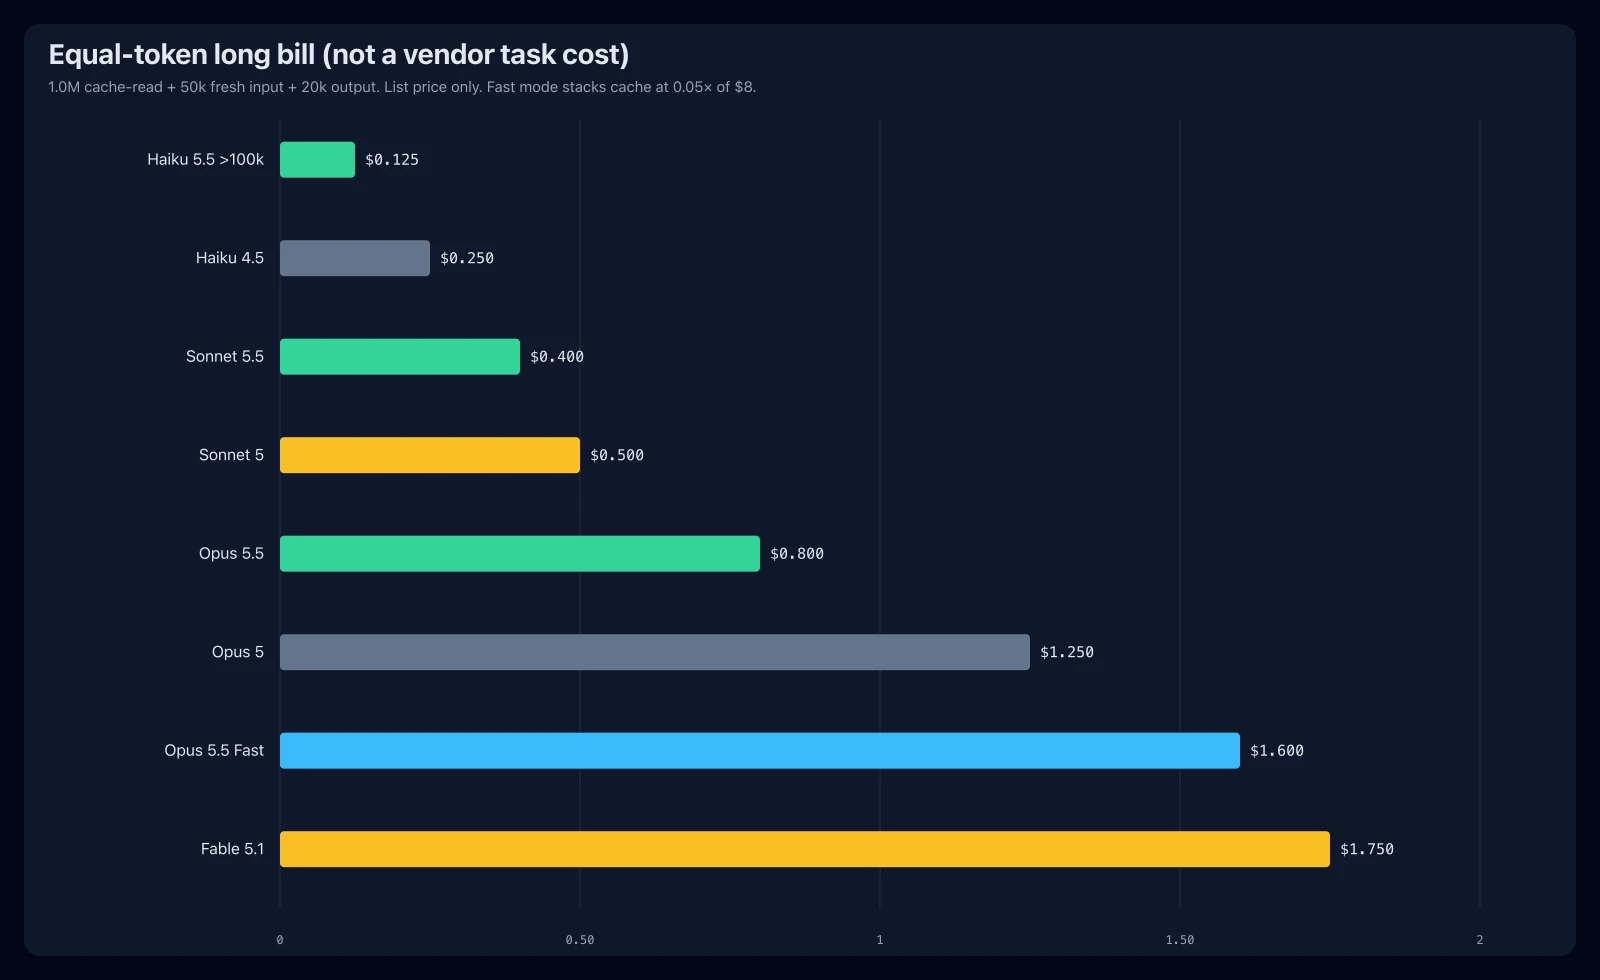
公式の「40% / 30% / 75% 安い」は二つが混ざる。定価が変わり、同じ作業のトークン数も変わる。下はトークンを固定し、定価だけ。
短いリクエストはキャッシュ読 8万、新規入力 1.5万、出力 4千。Prompt は 9.5万で、Haiku は低段。長いタスクはキャッシュ読 100万、新規 5万、出力 2万。Prompt は10万超で、Haiku は高段。
| モデル | 短い | 長い |
|---|---|---|
| Haiku 5.5 | $0.0043 | この比較で最良 $0.125 |
| Haiku 4.5 | $0.043 | この比較で最良 $0.250 |
| Sonnet 5.5 | $0.078 | この比較で最良 $0.400 |
| Sonnet 5 | $0.086 | この比較で最良 $0.500 |
| Opus 5.5 | $0.156 | この比較で最良 $0.800 |
| Opus 5 | $0.215 | この比較で最良 $1.250 |
| Opus 5.5 Fast | $0.312 | この比較で最良 $1.600 |
| Fable 5.1 | $0.370 | この比較で最良 $1.750 |
- 長いタスクでは Opus 5.5 が $0.80、前が $1.25 で 36%減。公式の約40%には「トークンが減った」分も入り、それはこの表にない。
- Sonnet 5.5 は $0.40、前は $0.50 でちょうど20%減。キャッシュがほぼ無いなら定価は Sonnet 5 と同じで、節約はトークン減だけ。
- 短いリクエストの Haiku 5.5 は $0.0043。Sonnet の約18分の1、Opus の約36分の1。サブタスクに置く理由はここ。10万を超えるとこの差は縮む。
Sonnet のマスが高くても、Opus は捨てない
 画像を拡大
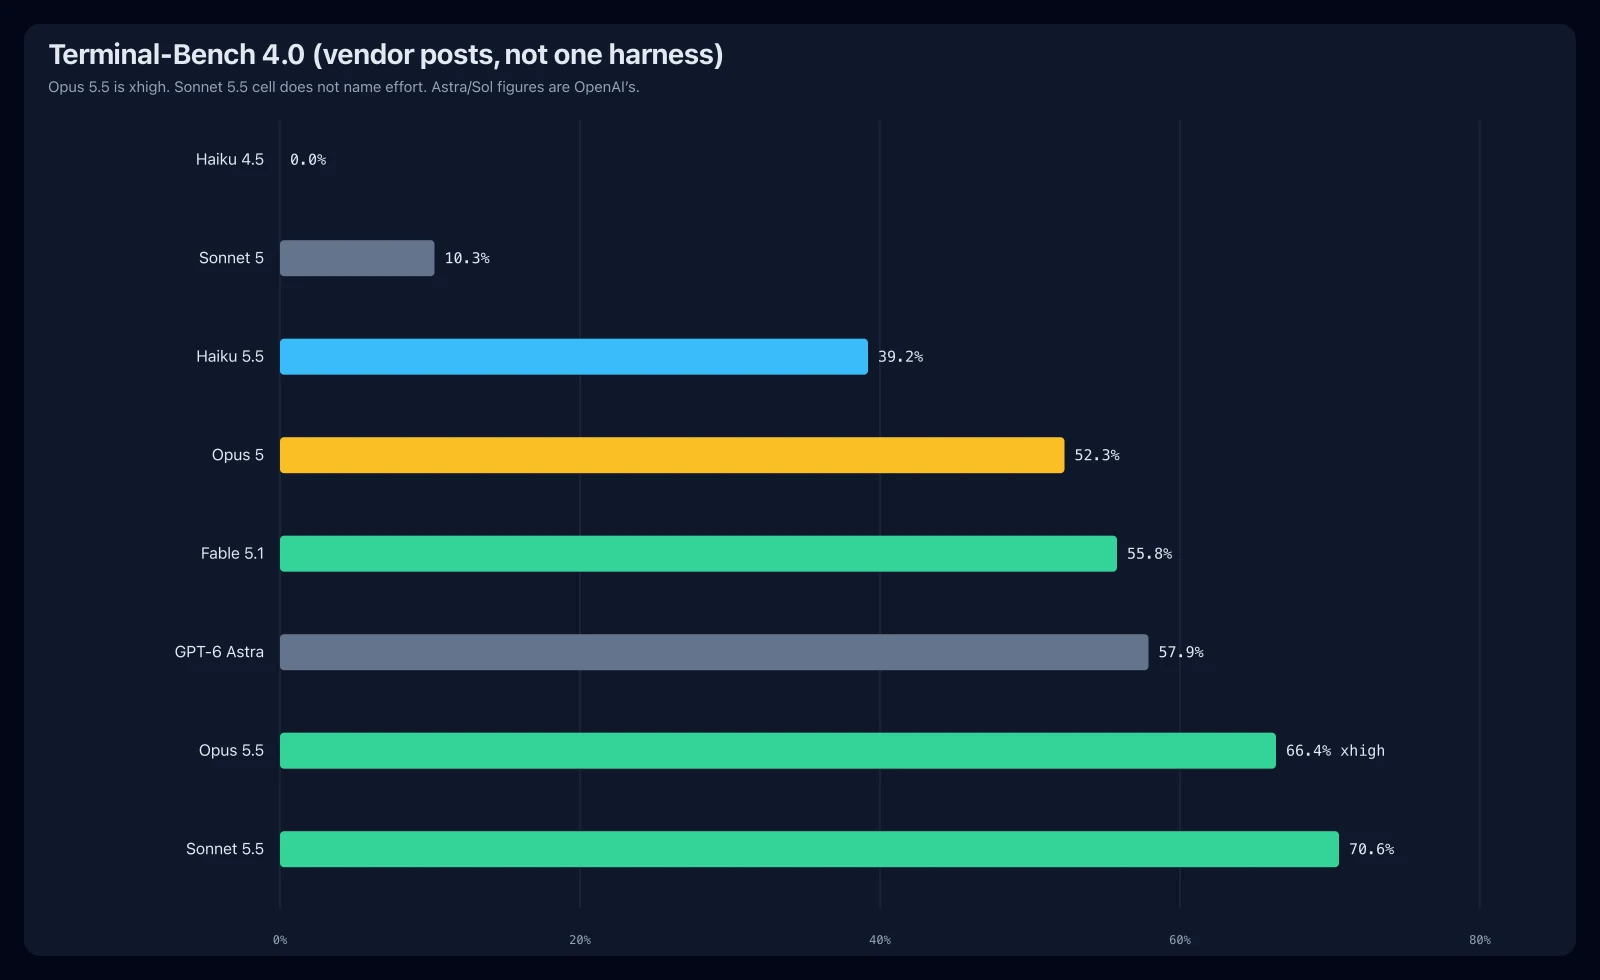
表は見出しの数字だけ。表より、この三つを覚えたほうが役に立つ。
| テスト | Haiku 5.5 | Sonnet 5.5 | Opus 5.5 |
|---|---|---|---|
| Terminal-Bench 4.0 | 39.2% | この比較で最良 70.6% | 66.4% |
| FrontierCode | 46.4% | 52.1% | この比較で最良 54.4% |
| CursorBench | — | 55.5% | この比較で最良 57.8% |
| GDPval-AA | 1620 | 1844 | この比較で最良 1846 |
- Terminal-Bench では Sonnet が 70.6%、Opus が 66.4%。Opus は最高段 xhigh と脚注がある。Sonnet のマスには段がない。前の Sonnet は 10.3%、Haiku 4.5 は 0。前世代に対しては断層で、Opus に対して「全面的に超えた」ではない。
- FrontierCode は変更がマージできるか。Opus は約 54%。Sonnet は xhigh で 52.1%、max では 46.2% に落ちる。レビューがサブタスクに分かれ、範囲外を直したため。effort を最大にするとこの表は悪くなる。
- CursorBench の Sonnet 55.5% は、Opus の medium 52.5% と max 57.8% のあいだ。安定した2位ではない。GDPval はほぼ同点、1844 対 1846。Haiku の投稿は Sonnet を 1840 と刷っていて、4点差は同じ段と見る。
- 混ぜない図が二つ。Chartography はツールありとなしが混在。OSWorld の partial と offline も別物。
- Opus が勝っていないマス:AutomationBench では GPT-6 Astra が 41.4%、Opus が 40.0%。科学の端末タスクでは Astra 64.6%、Opus 58.7%。安全の差し戻しは点数を下げる。別モデルが代わりに解くため。
Anthropic 自身が、この点差は社内で使うときの差より広いと書いている。開いた判断が続く仕事は、依然 Opus。
乗り換えると変わる三つのこと
- Thinking。 Opus 5.5 は切れない。ツール呼び出しのあいだの文字は、既定では空の thinking ブロックに戻る。進捗表示にしていると、display を変えるまで間が黙る。Sonnet を thinking off で使っていたなら、先に between_tools にしてから移る。
- アカウントに縛られる。 Opus 5.5 は 2026-08-31 以降の API アカウントで、すでに書いた前文を書き換えて推論を抜き出せない。Sonnet 5.5 はこれを持つ最初の Sonnet。会話を別アカウントに移す、Claude Code の途中でアカウントを替える、で踏む。
- 安全の差し戻し。 サイバー系は、Opus 5.5 の多くが Opus 4.8 に、Sonnet 5.5 が Sonnet 5 に落ちる。普通のバグ修正は残る。Haiku は防御がやや広いが、侵入試験は止める。生物の研究開発を Opus が遮るなら Life Sciences の審査。Sonnet と Haiku の生物防護は Sonnet 5 と同じ。
ゼロデータ保持は Opus 5.5 と Sonnet 5.5 に書いてある。Haiku の稿にはないので、ここには足さない。Max と Team の月次クレジットは割引ではない。5x は $100、20x は $200、Team は最大 $500 をメンバーで共有。